
Libro blanco: comprender la búsqueda semántica y crear un motor paso a paso
1. Introducción
La búsqueda es esencial en el comercio electrónico B2B y B2C, los mercados digitales, los servicios SaaS y los medios. Este libro blanco recorre los métodos tradicionales y semánticos, sus limitaciones y la implementación de un motor con un modelo de lenguaje de código abierto.
2. Búsqueda por palabras clave
Normalmente pensamos en buscar coincidencias exactas para una consulta dentro de un corpus o conjunto de datos.
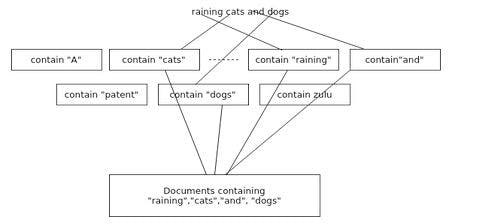
La búsqueda por palabras clave relaciona palabras entre sí, con sinónimos o con términos parecidos.
Su limitación es no incorporar el significado de la consulta. Puede ignorar términos relacionados y evaluar cada palabra por separado, en lugar de interpretar la unidad semántica.
Esto perjudica la experiencia porque suele devolver falsos positivos: resultados irrelevantes o solo parcialmente relacionados.
Existen técnicas para mejorar una implementación básica. Ninguna sirve para todos los casos y deben evaluarse individualmente. Las más habituales son:
- Ponderación de términos: TF-IDF, frecuencia del término por frecuencia inversa de documento; mide la relevancia combinando su frecuencia en un documento y la inversa de su frecuencia en el corpus.
- Expansión de consultas: tokenización, eliminación de palabras vacías, como «es» o «en», y reducción a raíces o lemas.
- Búsqueda de frases: n-gramas, secuencias contiguas de n elementos que incorporan el contexto inmediato.
3. Búsqueda semántica
La búsqueda semántica incorpora el significado de los términos según su contexto. Analiza las relaciones entre palabras para comprender la intención y devolver resultados más relevantes y precisos.
3.1. Representaciones vectoriales
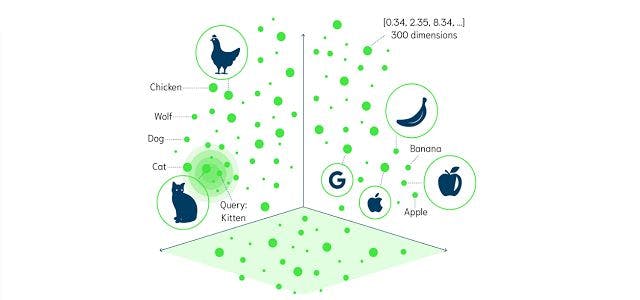
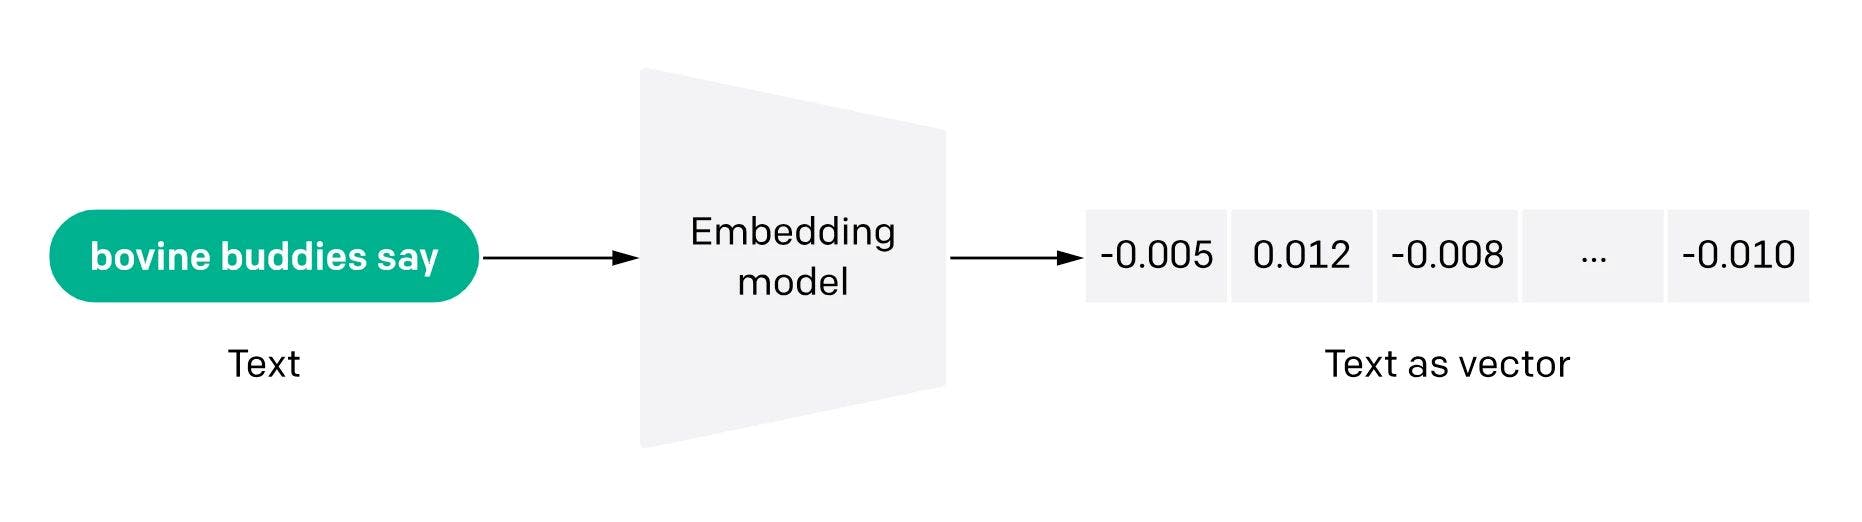
El significado se captura mediante una representación vectorial: una codificación numérica de datos como texto, imágenes o audio que facilita su análisis para tareas posteriores, como predicción o clasificación.
Se obtiene con modelos entrenados para convertir objetos en vectores. Suelen tener muchas dimensiones, a menudo más de mil, y ser densos, con valores no nulos, a diferencia de representaciones dispersas como la codificación one-hot. Esto permite recoger relaciones complejas y analogías y utilizar el espacio de forma más eficiente.
3.2. Representaciones en procesamiento del lenguaje
Podemos distinguir modelos de palabras y de frases, y enfoques estáticos o dependientes del contexto:
- Las representaciones de palabras codifican términos individuales; la representación de frases amplía ese principio a oraciones completas.
- Las representaciones contextuales incorporan información como las palabras cercanas o el tema del documento.
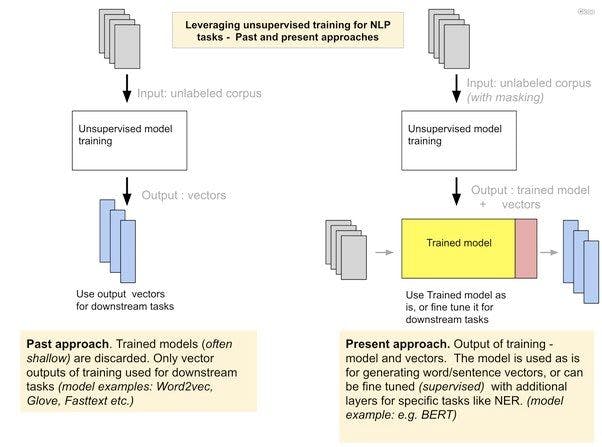
Existen varias arquitecturas. Los modelos más usados se basan en redes neuronales profundas, pero difieren en estructura y entrenamiento. Por ejemplo, Word2Vec y GloVe se basan en redes recurrentes, mientras que los modelos más recientes, como BERT, utilizan transformadores.
Algunos modelos populares son:
- Word2Vec: incluye Continuous Bag-of-Words, que predice una palabra según su contexto, y Skip-N Gram, que predice el contexto a partir de la palabra.
- GloVe: Global Vectors for Word Representation, entrenado con una matriz global de coaparición de palabras de un corpus.
- BERT: Bidirectional Encoder Representations from Transformers, un transformador con codificador bidireccional y variantes de 110 y 340 millones de parámetros.
Muchos modelos publican pesos preentrenados con grandes corpus como Wikipedia o Common Crawl. Suelen bastar cuando no se utiliza un lenguaje especializado poco habitual, porque sus datos diversos permiten capturar muchas relaciones sintácticas y semánticas.
3.3. Medidas de similitud
Una vez obtenidas las representaciones del corpus, podemos calcular su proximidad en el espacio vectorial.
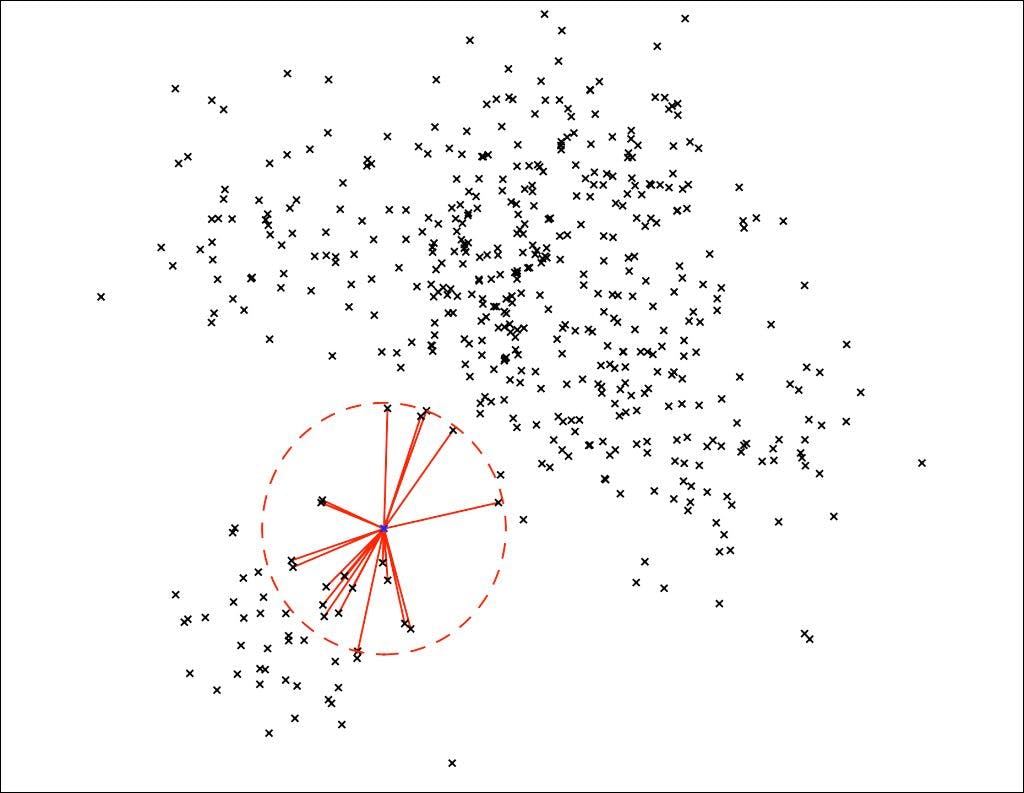
Primero calculamos el vector de la consulta y recuperamos los vectores más cercanos. Es la búsqueda de vecinos más próximos (NNS).
Para determinar esa proximidad hay que definir una métrica.
Las métricas cuantifican la similitud o distancia entre vectores. La elección depende mucho del problema.
Entre las más habituales están:
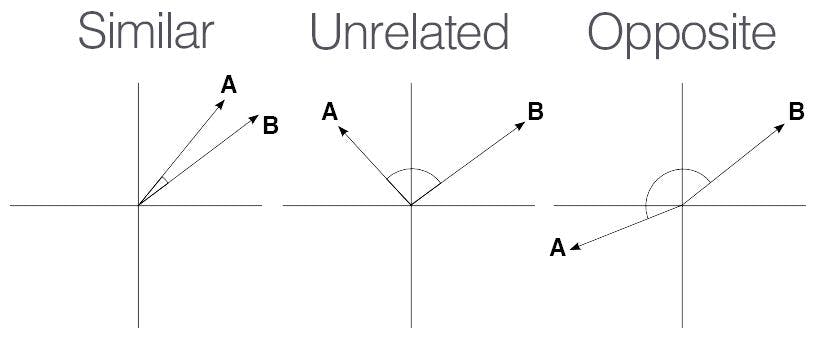
- Similitud del coseno: mide el coseno del ángulo y refleja la diferencia de dirección, en lugar de magnitud.
- Distancia euclídea: mide la distancia en línea recta entre dos vectores.
- Distancia Manhattan o L1: suma las diferencias absolutas entre coordenadas y es relevante cuando las dimensiones no son directamente comparables.
3.4. Búsqueda de vecinos más próximos
Existen varios enfoques. Los sistemas grandes suelen utilizar algoritmos aproximados (ANN) en lugar de fuerza bruta, que calcula todas las distancias entre vectores con complejidad cuadrática, O(n²).
La fuerza bruta garantiza el resultado exacto, pero su coste de cálculo la hace inviable para almacenes grandes.
Algunos algoritmos ANN habituales son:
- Locality-Sensitive Hashing (LSH): aplica funciones hash para agrupar elementos similares.
- Random Projection Forest (rpForest): reduce dimensiones proyectando los datos en subespacios aleatorios y repite el proceso para formar un bosque de proyecciones.
- Árboles K-D: extensión de KNN que organiza los datos jerárquicamente para acelerar la búsqueda.
- Annoy (Approximate Nearest Neighbors Oh Yeah): construye un bosque de árboles binarios para buscar vecinos aproximados.
3.5. Almacenes vectoriales
Las representaciones calculadas deben almacenarse para reutilizarlas en consultas posteriores sin recalcularlas.
Las bases vectoriales están diseñadas para almacenar y gestionar vectores y optimizar búsquedas de similitud en muchas dimensiones. Sus algoritmos, como ANN, pueden ser mucho más rápidos que recorrer todos los vectores.
Entre las opciones populares de bases vectoriales de código abierto se encuentran Faiss, desarrollada por Facebook, Pinecone, Chroma y Milvus. Proyectos como pgvector añaden búsqueda por similitud a Postgres y otros sistemas consolidados.
4. Enfoques híbridos
La búsqueda puramente semántica puede no ofrecer la mejor experiencia porque carece de información en tiempo real sobre existencias, descuentos, promociones o interacciones anteriores.
Los enfoques híbridos incorporan metadatos para filtrar y ordenar los resultados semánticos.
5. Un caso práctico
Presentamos un motor semántico para un catálogo de comercio electrónico.
Utiliza un modelo preentrenado para inferir el significado de las descripciones de productos y permitir buscar por su sentido.
El código está en nuestro repositorio de GitHub. Incluimos un archivo docker-compose para configurar localmente las dependencias externas y reproducir el ejemplo.
Utilizamos Wayfair Annotation Dataset (WANDS), con más de 40.000 productos únicos y metadatos, incluidas descripciones.
Elegimos all-MiniLM-L12-v2, una versión ajustada para representar frases del modelo MiniLM, un transformador de Microsoft pensado como alternativa eficiente a modelos mayores: 33 millones de parámetros frente a 109 millones en BERT.
La implementación sigue estos pasos:
- Cargar, preprocesar y almacenar el catálogo con Spark.
- Descargar el modelo preentrenado desde HuggingFace Model Hub mediante sentence_transformers.
- Utilizar LangChain para cargar datos, calcular vectores de productos y almacenarlos en Chroma.
- Utilizar MLFlow para crear un modelo desplegable.
5.1. Cargar, preprocesar y almacenar el catálogo
Elegimos Spark para cargar el conjunto original, procesarlo y guardar resultados. Dado el alcance y tamaño de esta prueba, también podríamos utilizar Pandas, una opción en memoria con una API más sencilla, ya que no aprovechamos la naturaleza distribuida de Spark.
Guardamos los datos en Parquet, un formato por columnas con compresión y codificación eficientes.
5.2. Descargar el modelo
Utilizamos sentence-transformers para descargar all-MiniLM-L12-v2. No usamos directamente Transformers de Hugging Face porque no ofrece de serie representaciones de frases. sentence-transformers añade esa capacidad sobre la biblioteca.
Leemos el modelo mediante el adaptador HuggingFaceEmbeddings de LangChain para aprovechar las abstracciones de LangChain para documentos y las utilidades vectoriales.
La interfaz unificada de LangChain mediante HuggingFaceEmbeddings también permite evaluar otros modelos preentrenados sin modificar el resto de la implementación.
5.3. Calcular los vectores de productos
Los adaptadores de carga y Chroma de LangChain permiten cargar los datos procesados, calcular sus vectores con el modelo y almacenarlos.
5.4. Crear un modelo desplegable con MLFlow
MLflow es una plataforma abierta para gestionar experimentación, reproducibilidad y despliegue durante el ciclo de vida del aprendizaje automático.
Utilizamos mlflow.pyfunc.PythonModel, un modelo genérico que encapsula código Python para obtener predicciones. Define un formato de almacenamiento y utilidades para guardar y cargar modelos.
Encapsular el modelo en mlflow.pyfunc.PythonModel permite:
- Guardarlo en disco mediante mlflow.pyfunc.save_model, en un formato autónomo que se puede recuperar para producir predicciones.
- Servir predicciones por API REST con mlflow.pyfunc.serve o mediante inferencia por lotes.
6. Conclusión
El paso de palabras clave a métodos semánticos mejora la precisión y la experiencia en sectores que dependen de recuperar información. El ejemplo de MiniLM-L12-v2 y WANDS muestra los beneficios prácticos de interpretar el contexto. Este enfoque favorece mejores decisiones, interacciones y operaciones e impulsa la innovación y la competitividad.
7. ¿Cómo puede ayudar Nieve?
Integramos distintos modelos de lenguaje, incluidos los de OpenAI, y tecnologías como ChatGPT en productos y servicios. Creamos aplicaciones prácticas que mejoran la experiencia, automatizan tareas y permiten interacciones inteligentes.
Nuestros servicios de diseño y entrenamiento de modelos permiten extraer información útil mediante análisis predictivo, detección de anomalías y decisiones basadas en datos. Te acompañamos en cada paso.
También desarrollamos complementos de ChatGPT adaptados a tus necesidades, utilizables desde su interfaz para mejorar las conversaciones y la productividad al interactuar con tus propios productos y servicios.
Con Nieve puedes aprovechar ChatGPT y los modelos modernos para innovar y crecer. Análisis de sentimientos, informes, guías interactivas, chatbots, complementos o búsqueda conversacional: tenemos experiencia para convertir esas posibilidades en proyectos concretos y transformar la relación con tus clientes.
Contacto:
Mikaela Nyman, directora general
Nieve Consulting Services SL
mikaela@nieveconsulting.com
+34 610 096 740
+358 50 553 8001
Ingeniero de aprendizaje automático